
推理为什么贵:从显存带宽看加速技术栈
自回归解码是显存带宽受限问题,这是所有加速技术的共同出发点。梳理投机解码、KV 缓存、量化、MoE、批处理调度五族的原理与实测数字,以及为什么技术能叠加但收益不是乘法——高并发下投机解码会坍缩到一点三倍。
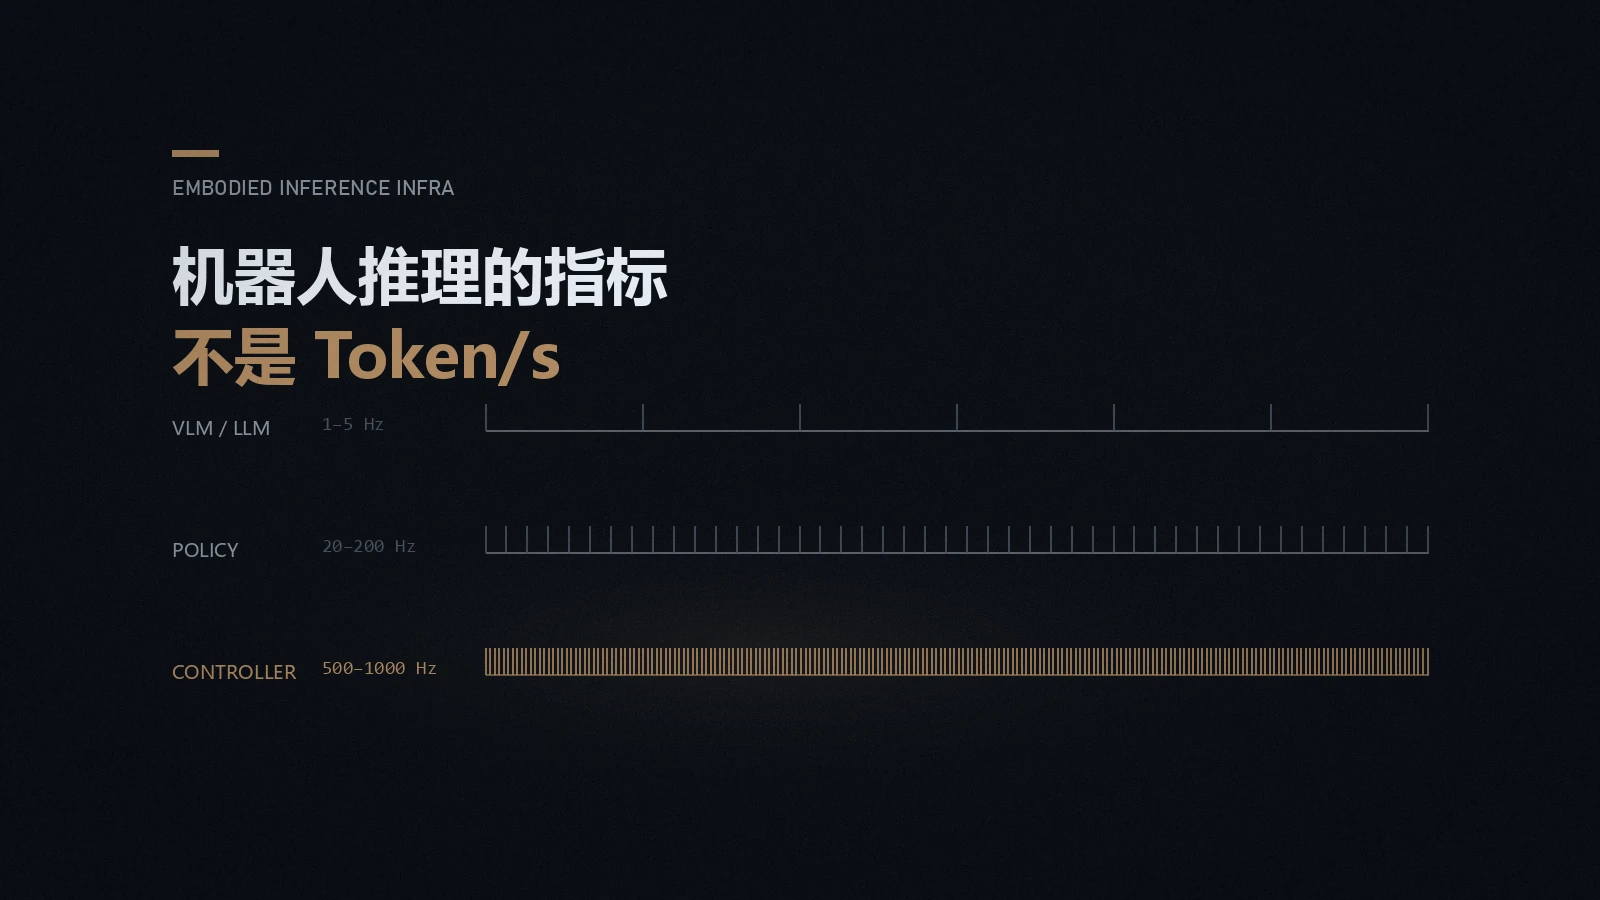
机器人推理的指标不是 Token/s
LLM 推理基础设施优化的是 Token 吞吐,机器人要的是 Observation → Action 的闭环延迟。梳理两者在缓存对象、调度目标、延迟语义上的根本差异,以及目前最接近「机器人 vLLM」的几条技术路线。




