
让 AI 去发现算法:进化搜索能走多远
语言模型作变异算子、评测器作裁判、进化搜索作导航——这套三件套已经改进了矩阵乘法的乘法次数、让排序算法进了标准库、恢复了数据中心百分之零点七的算力。但评测器既是命门也是软肋,奖励破解的案例已被系统收录。
推理为什么贵:从显存带宽看加速技术栈
自回归解码是显存带宽受限问题,这是所有加速技术的共同出发点。梳理投机解码、KV 缓存、量化、MoE、批处理调度五族的原理与实测数字,以及为什么技术能叠加但收益不是乘法——高并发下投机解码会坍缩到一点三倍。
塞得进不等于用得好:长上下文与上下文工程
宣称 128K 的模型有效长度可能只有 64K,去掉词汇线索后十三个模型里十一个在 32K 跌破基线一半。梳理名义窗口与有效窗口的鸿沟、三条算法路线、工程层三大件,以及长上下文、检索与记忆该怎么选。
会做和会想:RLVR 到底扩展了什么
可验证奖励强化学习是小 k 更强还是真扩展了能力边界?两篇立场相反的代表工作给出了各自的硬数字:一边发现大 k 时基座反超,一边在低支持空间任务里让基座从零变到可解。梳理这场争论的判据、指标与边界条件。
一千条样本够吗:小数据如何激发大推理
强基座上一千条精选长思维链就能把竞赛数学从个位数拉到六成,成本仅七张 H100 的 GPU 时。但精选是否必要正在被推翻,而评测噪声比效果本身还大:三十道题、单点提升常常落在噪声带里。
想久一点就有用吗:推理时扩展的能与不能
采样、搜索、验证、预算分配四层方法全谱系,加上一条被反复印证的结论:生成容易选择难——覆盖率能涨四个数量级,但多数投票约一百个样本后就饱和。梳理成本反转让小而多训变得划算,以及知识密集型任务上算力为何失效。
补个向量库是不够的:Agent 记忆的四条路线与一场信任危机
Agent 记忆已成为独立工程学科:四条实现路线、四类记忆操作、以及一场至今没有中立复现的基准争议。梳理 mem0 与 Zep 各自的证据、长上下文与记忆的成本-延迟取舍,以及为什么评测是这个领域最大的短板。
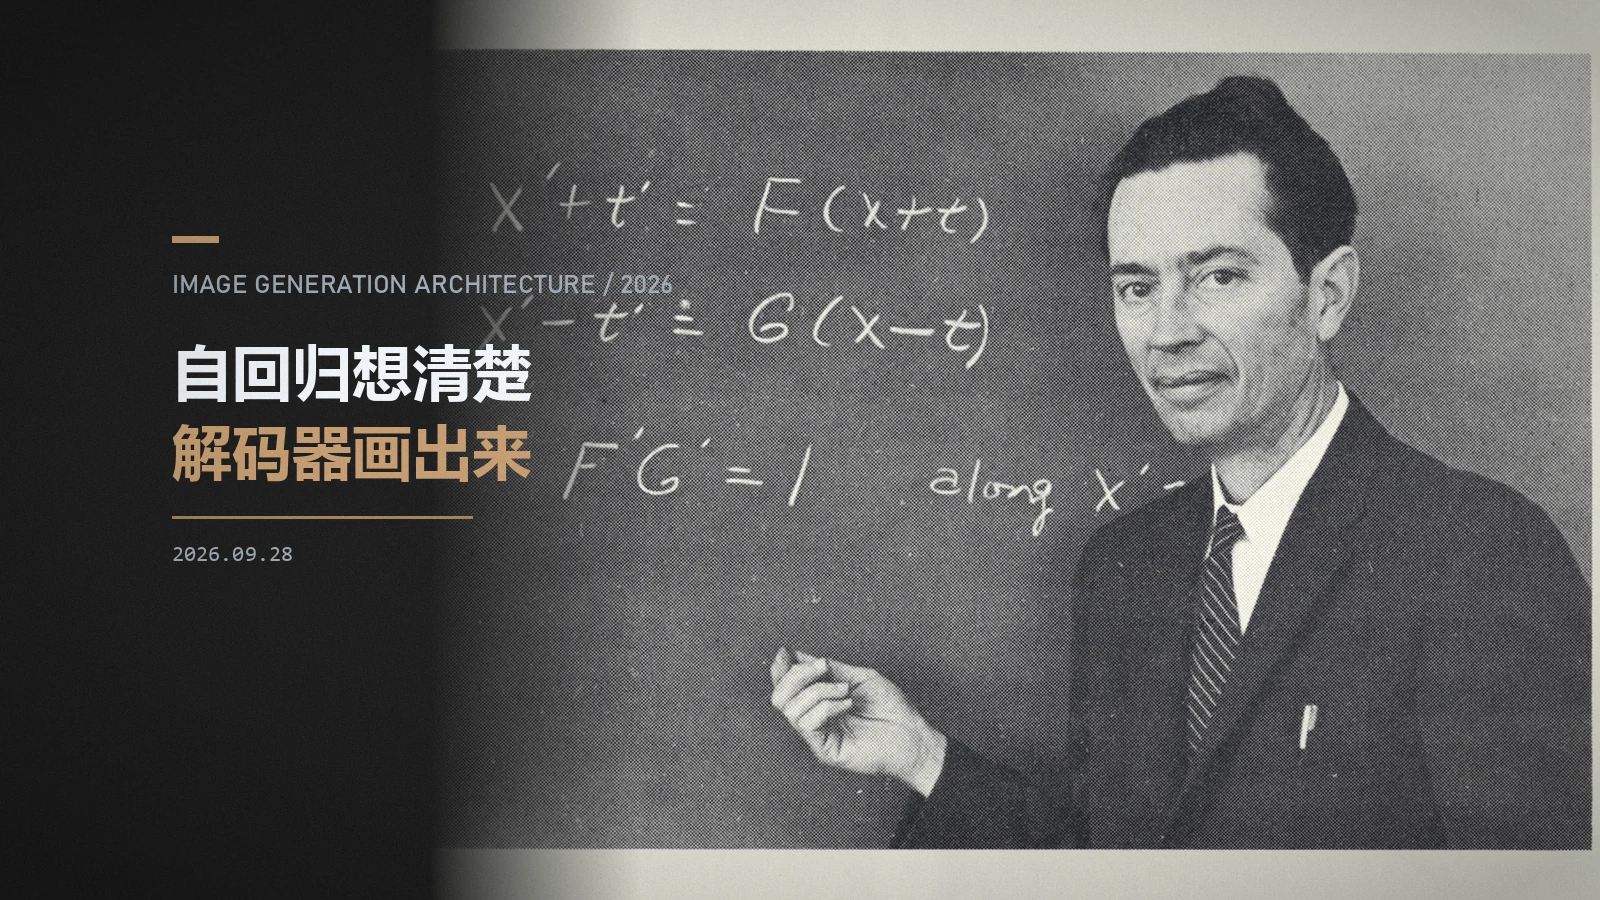
GPT Image 的架构,写在一张白板上
OpenAI 从未公开 GPT Image 的网络结构与参数量,但发布博文里的一张架构白板、系统卡原文和 API 行为拼出了它的形状:自回归先验负责想清楚画什么,强大的解码器负责画得像;而改图整图重生成、像素级不可保,正是这条架构路线的直接代价。
直接读出答案:从 GPT 双头到 Jev 的一条线索
闭集判断为什么要先生成一串文本?这个问题在 Jev 出现之前已经问了八年:从 GPT 的双头模型、DETR 和 Perceiver IO 的 query 读出、Hydragen 的共享 prefix,到 FIRST 的首 token 排序,三条线索最终在 Jev 汇合。
一个 Backbone,三种输出:2026 年 VLA 架构正在分岔
梳理 2026 年 13 篇 VLA 论文:研究重点已经从「能不能工作」转向「世界表征形成之后,决策和动作该用什么方式读出来」,并正在分成四条路线和三种互相对立的架构。




