换一台机器人就不灵了:VLA 跨本体泛化卡在哪
拆解 VLA 跨本体泛化的核心障碍——动作空间异构,以及从离散 token 到物理对齐的四代解法。重点梳理一份系统消融的实证:物理对齐比数据规模更重要,异构数据朴素混合反而带来负迁移(LIBERO 上 77.3% 逐级降到 72.1%)。
先想象,再动手:世界动作模型这一年
半年内两篇独立综述把世界动作模型(WAM)立成正式方向。梳理它的定义边界、三种工程实现与产业合流,以及正反两面证据:最强证据来自把世界模型当训练器而非直接当策略,而联合评估协议至今缺失。
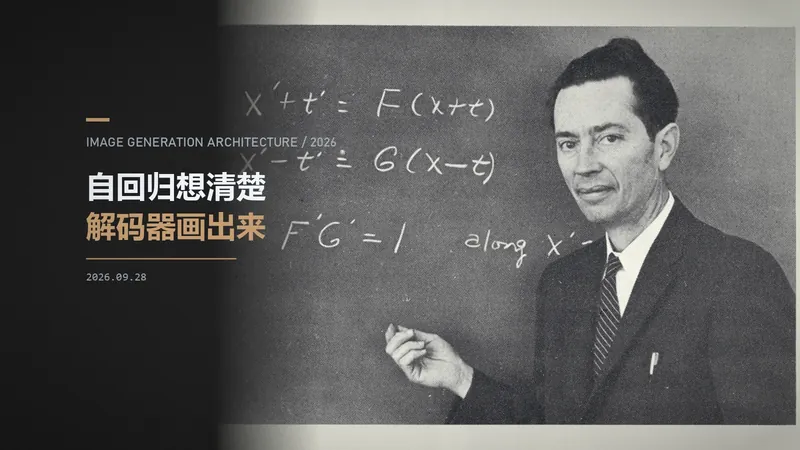
GPT Image 的架构,写在一张白板上
OpenAI 从未公开 GPT Image 的网络结构与参数量,但发布博文里的一张架构白板、系统卡原文和 API 行为拼出了它的形状:自回归先验负责想清楚画什么,强大的解码器负责画得像;而改图整图重生成、像素级不可保,正是这条架构路线的直接代价。
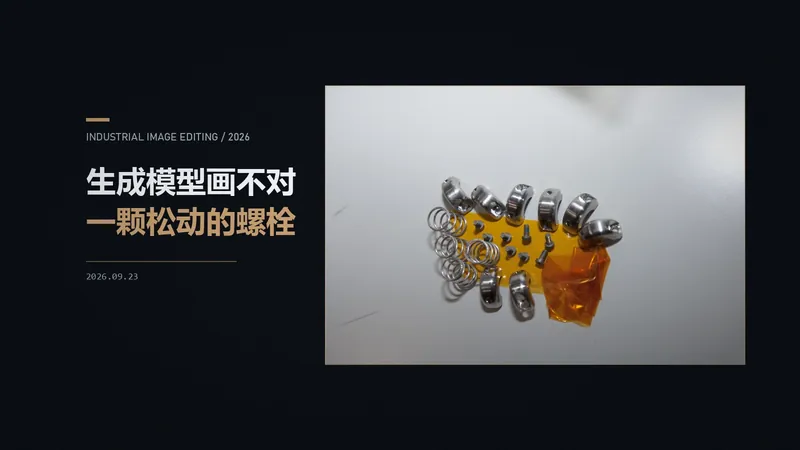
生成模型画不对一颗松动的螺栓
做工业巡检缺陷图时发现,通用图生图模型改小色块和小组件很不可靠。从失败模式出发,说明为什么机械缺陷必须交给确定性几何编辑,AI 只负责补洞和纹理。
直接读出答案:从 GPT 双头到 Jev 的一条线索
闭集判断为什么要先生成一串文本?这个问题在 Jev 出现之前已经问了八年:从 GPT 的双头模型、DETR 和 Perceiver IO 的 query 读出、Hydragen 的共享 prefix,到 FIRST 的首 token 排序,三条线索最终在 Jev 汇合。
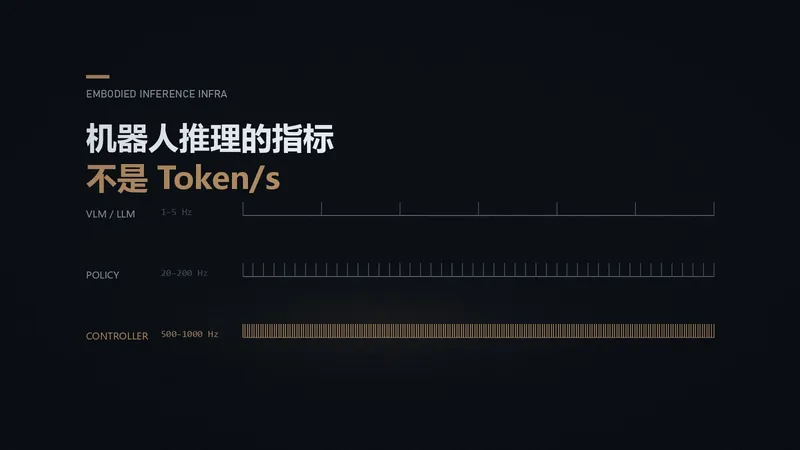
机器人推理的指标不是 Token/s
LLM 推理基础设施优化的是 Token 吞吐,机器人要的是 Observation → Action 的闭环延迟。梳理两者在缓存对象、调度目标、延迟语义上的根本差异,以及目前最接近「机器人 vLLM」的几条技术路线。
一个 Backbone,三种输出:2026 年 VLA 架构正在分岔
梳理 2026 年 13 篇 VLA 论文:研究重点已经从「能不能工作」转向「世界表征形成之后,决策和动作该用什么方式读出来」,并正在分成四条路线和三种互相对立的架构。
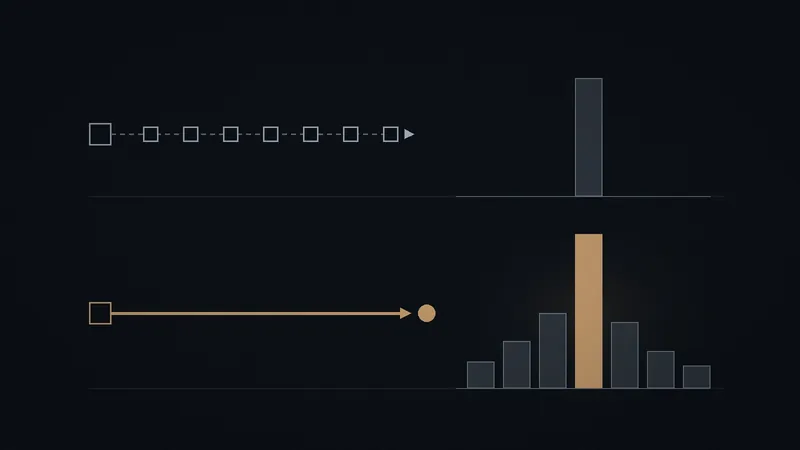
Jev 调研:便宜和快是真的,校准还没被证明
拆解 TypeSafe 的 Jev(System One 模型类)官方材料、第三方复现与对抗性评测:便宜、低延迟、零格式错误已被独立验证,而支撑其全部叙事的校准置信度至今没有论文或可靠性曲线。
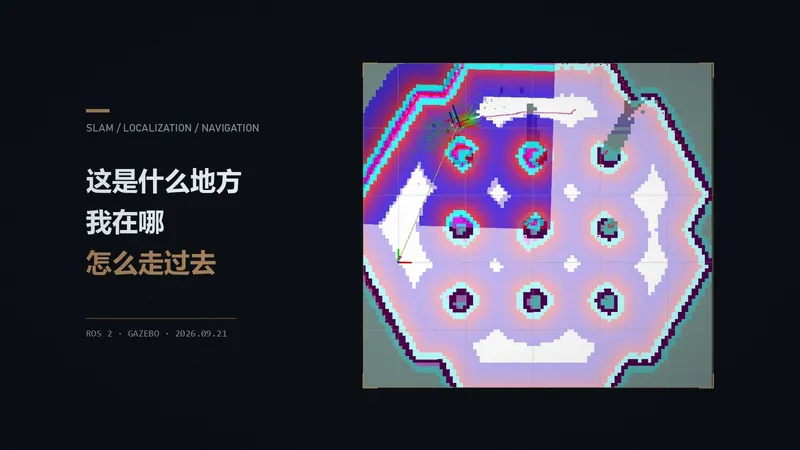
跑通一遍 SLAM 和 Nav2 之后,我理解的建图、定位与自主导航
从传感器、运动估计、SLAM、有图定位到全局规划、局部控制与恢复行为,把移动机器人自主导航整条链路串一遍,并附上自己用 Gazebo + ROS 2 跑出来的实测数字。
特斯拉纯视觉与国产智驾:传感器不同,终点可能相同
从摄像头、激光雷达、毫米波雷达和定位系统出发,梳理特斯拉纯视觉与国内多路线智驾方案的差异,并讨论自动驾驶未来可能走向何处。